شرح تعقيد الوقت وتعقيد المساحة للخوارزمية
تخيل برنامجين يؤديان نفس المهمة تمامًا. أدخل لكل منهما ألف سجل ولن تستطيع التمييز بينهما. لكن أدخل لهما مليار سجل، وسينتهي أحدهما قبل أن ترفع إصبعك عن زر الإدخال بينما لا يزال الآخر يعمل بلا توقف.
نفس الحاسوب المحمول. نفس البيانات. ما يفرق بينهما هو تعقيد الوقت، وهو مجرد اسم لمدى سرعة تضخم عبء عمل الخوارزمية كلما زادت المدخلات التي تقدمها لها.
سنتناول معنى المصطلح فعلياً، وكيف يُكتب باستخدام ترميز Big O، وكيفية حسابه من خلال جزء حقيقي من التعليمات البرمجية، وأين يظهر تعقيد المساحة. ثم، في النهاية، نصل إلى النقطة التي يتوقف فيها كل هذا عن كونه مجرد واجب منزلي ويبدأ في إنفاق أموال حقيقية: العقود الذكية.
ما هو التعقيد الزمني للخوارزمية؟
دعنا ننسى الثواني للحظة. التعقيد الزمني يعتمد على الخطوات. المقارنات، عمليات الإسناد، بعض العمليات الحسابية هنا وهناك، ثم تكتب المجموع كدالة لـ n، وهو حجم المدخلات.
إليكم أكثر وظيفة مملة يمكن تخيلها:
دالة بايثون print_all(items): for item in items: print(item)
عشرة عناصر؟ عشر رحلات عبر المسار الدائري. عشرة آلاف؟ عشرة آلاف رحلة.
يصعد العمل في خط مستقيم بجوار المدخلات، لذلك نسميه O(n).
الآن، ربما تكلف كل رحلة ثلاث عمليات صغيرة بدلًا من واحدة. حسنًا، هذا يعني 3ن. لا أحد يهتم، بصراحة، لأن مضاعفة القائمة لا تزال تضاعف العمل، وهذا المنحنى المتنامي هو ما نريده. يتم تجاهل الرقم الدقيق عمدًا.
لهذا السبب أيضاً، تركز جميع دورات هياكل البيانات والخوارزميات ونصف مقابلات البرمجة على تعقيد الوقت. فإذا استطعت استنتاج تعقيد خوارزمية ما بمجرد النظر إليها، يمكنك تخمين كيفية أدائها على بيانات إدخال لم تختبرها من قبل، وهي في بيئة الإنتاج تشكل معظم البيانات.
لماذا يُعد وقت التنفيذ مقياسًا غير دقيق للخوارزمية؟
فلماذا لا يتم تشغيل البرنامج باستخدام مؤقت؟ كثيرون يفعلون ذلك، وأنا أتفهم ذلك. لكن المشكلة تكمن في أن وقت التنفيذ يُضيف الكثير من الأمور التي لا علاقة لخوارزميتك بها.
- الأجهزة. سيعطيك جهاز الكمبيوتر المحمول الخاص بي الذي يبلغ من العمر خمس سنوات وجهاز التخزين السحابي الجديد تمامًا أرقامًا مختلفة تمامًا لنفس النص البرمجي.
- لغة البرمجة. اكتب نفس الحلقة في لغة C وفي لغة بايثون وقد ترى فرقًا يصل إلى 10 أضعاف، أو أكثر.
- ضغط النظام. يبدأ أحد برامج التحديث في الخلفية بالعمل، ويستيقظ جامع البيانات المهملة، وتكون ذاكرة التخزين المؤقت فارغة. تنتقل نتيجتك.
- أيًا كانت المدخلات التي حصلت عليها. يمكن لعملية فرز البيانات التي تعمل بكفاءة على البيانات شبه المرتبة أن تعمل ببطء على البيانات المختلطة.
تُعطيك ساعة الإيقاف قراءة واحدة على جهاز واحد بإدخال واحد. اسألها عن بيانات أكثر بمئة ضعف، ولن تحصل على شيء.
عدد الخطوات ثابت. نفس الخوارزمية، نفس المدخلات، وستحصل على نفس عدد الخطوات سواءً كان ذلك باستخدام Rust على خادم مركزي أو JavaScript على هاتف. لهذا السبب، يُعدّ تعقيد الوقت عاملاً حاسماً في المقارنة بين حلين قبل إجراء أي اختبارات قياس الأداء. مع ذلك، أنصح بإجراء اختبارات قياس الأداء لاحقاً، على الرغم من اختلاف الموضوع.
شرح رمز Big O وغيره من الرموز التقاربية
تُطلق الكتب الدراسية على هذا اسم الترميز التقاربي، وهو مصطلح يبدو أسوأ مما هو عليه في الواقع. عندما تدع قيمة n تصبح هائلة وتتوقف عن الاهتمام بالتفاصيل الصغيرة، فإن المضاعفات الثابتة والمدخلات الضئيلة تختفي، ولا يبقى سوى منحنى النمو. هناك ثلاثة منها جديرة بالمعرفة:
| الترميز | ما يصفه | المعنى الواضح | مثال |
|---|---|---|---|
| Big O، O(f(n)) | الحد الأعلى | لا ينمو الخوارزمية أسرع من f(n) | البحث الخطي هو O(n) |
| أوميغا الكبيرة، Ω(f(n)) | الحد الأدنى | تحتاج الخوارزمية إلى عمل لا يقل عن f(n) | أي نوع من أنواع فرز المقارنة هو Ω(n log n) |
| بيج ثيتا، Θ(f(n)) | مجلد بإحكام | تتطابق الحدود العليا والسفلى | فرز الدمج هو Θ(n log n) |
في الواقع، ستسمع مصطلح Big O في حوالي 95% من الحالات. يحدد هذا المصطلح حدًا أقصى، ما يعني أن وقت التشغيل لن ينمو أسرع من المعدل الموجود بين القوسين. في أول مراجعة برمجية لي في وظيفة حقيقية، كتب مطور برامج كبير "O(n²), pls fix" بجانب حلقة متداخلة، وكان يقصد أن تعقيد الوقت في أسوأ الحالات تربيعي، وأن القائمة على وشك أن تصبح أطول بكثير.
تُستخدم خوارزميتا أوميغا وثيتا بشكل أساسي في مقررات تحليل الخوارزميات الجامعية، ولا أظن أنني استخدمت أيًا منهما في العمل منذ سنوات. تتفوق خوارزمية Big O لأنها تجيب على السؤال الذي يطرحه الناس في الاجتماعات، وهو: "ما مدى سوء الوضع إذا تضاعف حجم البيانات ثلاث مرات؟"
هناك تفصيل تقني واحد أربكني لبعض الوقت. بما أن Big O هو مجرد حد أقصى، فإن دالة O(n) هي أيضًا O(n²)، بالمعنى الدقيق للكلمة، تمامًا كما أن الشخص الذي طوله 5 أقدام "أقل من 7 أقدام". صحيح وغير مفيد. الجميع يذكر أضيق حد يمكنهم تبريره، وسأفعل الشيء نفسه.
فئات التعقيد الزمني الشائعة مع أمثلة
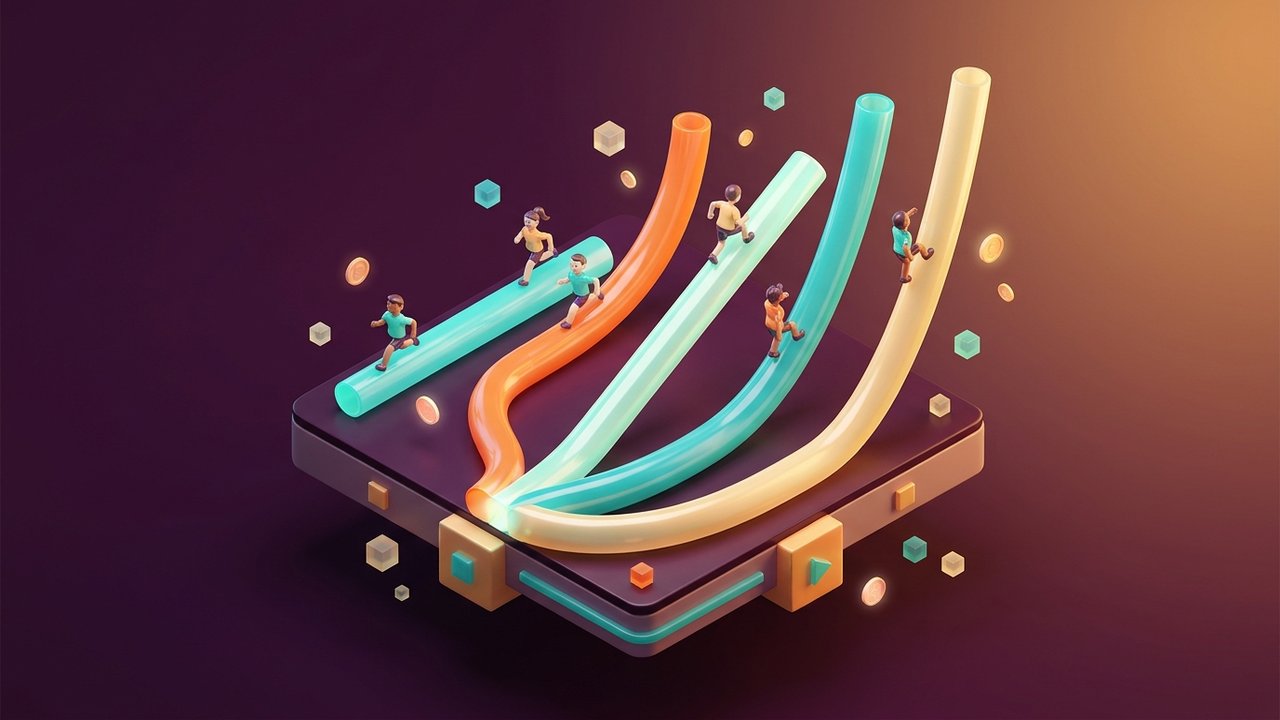
لن تجد الكثير من الفئات في البرمجة الحقيقية، ربما سبع فئات إذا احتسبنا الفئات المعقدة. هذا هو تقريبًا ما تكلفه كل فئة عند n = 1000:
| فصل | اسم | مثال نموذجي | العمليات عند n = 1000 |
|---|---|---|---|
| O(1) | ثابت | فهرس المصفوفة، البحث في جدول التجزئة | 1 |
| O(log n) | اللوغاريتم | البحث الثنائي | حوالي 10 |
| على) | خطي | مسح قائمة | 1000 |
| O(n log n) | حسابي خطي | فرز الدمج، الفرز السريع (المتوسط) | حوالي 10000 |
| O(n²) | التربيعية | الحلقات المتداخلة، فرز الفقاعات | مليون |
| O(2ⁿ) | النمو الأسي | فيبوناتشي التكراري الساذج | أكثر من مجرد ذرات في الكون |
| على!) | مضروب | بائع متجول يعتمد على القوة الغاشمة | أكبر من ذلك |
O(1): زمن ثابت
سواء احتوى قاموس بايثون الخاص بك على عشرة مفاتيح أو عشرة ملايين، فإن استخراج عنصر واحد باستخدام مفتاح واحد يكلف نفس التكلفة تقريبًا، وكذلك قراءة العنصر [5] من قائمة. هذا التسطيح هو جوهر الوقت الثابت.
O(log n): زمن لوغاريتمي
أعتبر هذه الخوارزميات بمثابة خوارزميات "تخمين العدد بين 1 و100"، حيث يستبعد كل تخمين نصف الاحتمالات المتبقية. ويقوم البحث الثنائي بذلك تحديدًا على قائمة مرتبة.
دالة البحث الثنائي في بايثون: `binary_search(arr, target): lo, hi = 0, len(arr) - 1` ...
مع وجود مليار عنصر مصنف، يحتاج الأمر إلى حوالي 30 مقارنة، بينما قد يستغرق الأمر مليار مقارنة كاملة عند المرور عليها واحدة تلو الأخرى، ولم أتوقف أبداً عن إيجاد ذلك مضحكاً.
O(n) و O(n log n)
تزور الخوارزمية الخطية كل عنصر عددًا ثابتًا من المرات، كما لو كنت تبحث عن أكبر رقم في عمود جدول بيانات بالعين المجردة. يُعدّ O(n log n) هو التعقيد الزمني الأمثل للفرز الجيد. تقوم خوارزمية فرز الدمج بتقسيم القائمة إلى عناصر منفردة (log n مستوى من التقسيم)، ثم تُجري عملية خطية واحدة لكل مستوى أثناء الدمج، لذا يبقى وقت تشغيلها ثابتًا سواءً وصلت البيانات مُرتبة أو غير مُرتبة.
O(n²) وأسوأ من ذلك
تحتوي الشيفرة التربيعية دائمًا تقريبًا على حلقة تكرارية داخل حلقة تكرارية أخرى، مثل فحص التكرار هذا الذي يقارن كل زوج:
دالة بايثون has_duplicate(items): for i in range(len(items)): for j in range(i + 1, len(items)): if items[i] == items[j]: return True return False
النمو الأسي والعاملي أسوأ بكثير. معادلة فيبوناتشي التكرارية في الكتب الدراسية تستمر في حل نفس المسائل الفرعية مرارًا وتكرارًا، لذا فإن كل زيادة بمقدار 1 في قيمة n تضاعف العمل تقريبًا. عند n = 20 لن تلاحظ الفرق؛ أما عند n = 60، فيمكنك طهي العشاء وتناوله وغسل الأطباق، ومع ذلك لن يكون العمل قد انتهى.
كيفية حساب التعقيد الزمني خطوة بخطوة
نادرًا ما تحتاج إلى برهان رسمي لحساب التعقيد الزمني. أستعرض هذه القائمة ذهنيًا، وهي تغطي معظم الأكواد التي أراها:
- حدد n. حدد حجم الإدخال: طول القائمة، أو عدد العقد في الرسم البياني، أو عدد الأرقام في العدد.
- احسب العمل في كل سطر. العبارات البسيطة (الإسناد، المقارنات، العمليات الحسابية) تكلف O(1).
- أضف كتلًا متسلسلة. حلقتان متتاليتان، كل منهما على n، تعطيان n + n = 2n.
- اضرب الكتل المتداخلة. حلقة تكرارية على n داخل حلقة تكرارية أخرى على n تعطي n × n = n².
- أسقط الثوابت. يصبح 2n هو n، ويصبح 500 هو 1.
- احتفظ فقط بالحد المهيمن. في n² + n، يصبح الجزء n² أكبر بكثير من باقي الحدود كلما زاد n.
حل سريع. يكون الناتج T(n) = 3n² + 5n + 2. أضف مليونًا: 3n² يساوي ثلاثة تريليونات، و5n يساوي خمسة ملايين. خطأ تقريبي. لنفترض أن O(n²)، انتهى.
الحلقات التي تتخطى بعضها بدلاً من المرور بجانب بعضها الآخر تكون أكثر دهاءً:
دالة بايثون `count_halvings(n)`: `steps = 0 while n > 1: n //= 2 steps += 1 return steps`
كل دورة تُقلل قيمة n إلى النصف، لذا تتوقف حلقة while هذه بعد حوالي log₂(n) دورة. وهذا هو الجواب الكامل لسؤال "متى يكون التعقيد الزمني O(log n)؟" إذا كان ما يتبقى يتقلص بمعامل ثابت في كل خطوة، فقد وصلت إلى التعقيد الزمني المطلوب.
تتطلب الخوارزمية التكرارية أداةً إضافية، وهي التكرار. تقوم خوارزمية فرز الدمج بعمليتين بنصف الحجم ثم عملية دمج، لذا فإن T(n) = 2T(n/2) + n. تُعدّ نظرية ماستر بمثابة دليل مختصر للتكرارات من هذا الشكل، وبالنسبة لهذه الحالة، فإنها تُخرج O(n log n).
وإحدى القواعد العامة التي أعتمد عليها كثيرًا في البرمجة التنافسية هي أن الجهاز العادي يُنجز حوالي 10⁸ عملية بسيطة في الثانية. هذا تقدير تقريبي جدًا، ولكنه كافٍ للتحقق من التعقيد الزمني للحل قبل إرساله. إذا كان n يساوي 10⁵، فإن O(n²) يُعادل حوالي 10¹⁰ عملية، وبالتالي ينتهي الوقت. أما O(n log n) فيُعادل أقل من مليوني عملية، وبالتالي يُنجز الحل بسلاسة.
تحليل أسوأ الحالات وأفضلها ومتوسط الحالات
عند إدخال بيانات مختلفة لنفس الخوارزمية، قد يتفاوت حجم العمل بشكل كبير. يوضح البحث الخطي ذلك بوضوح:
- في أفضل الأحوال: ما تريده موجود في المقدمة. مقارنة واحدة وستُستبعد.
- أسوأ الاحتمالات: أن يكون في النهاية تماماً، أو غير موجود على الإطلاق. هذا يعني إجراء عدد n من المقارنات.
- في الحالة المتوسطة: إذا كان من الممكن أن يكون في أي مكان باحتمالات متساوية، فستتحقق من حوالي n/2 في المتوسط. مع ذلك، لا يزال O(n).
اسأل مطورًا عن "تعقيد" شيء ما، وسوف يعطيك دائمًا تقريبًا أسوأ حالة لتعقيد الوقت، لأن هذا الرقم هو وعد يمكنك التخطيط بناءً عليه.
لنفترض أن واجهة برمجة التطبيقات (API) الخاصة بك تعالج الطلب في أسوأ الأحوال بزمن O(n). ممتاز، الآن أنت تعرف كيف يتصرف أبطأ طلب، كما أنك محميٌّ أيضًا في حال أرسل أحدهم بيانات غير صالحة عمدًا. هذا ما يفعله البعض بالفعل: إذا اكتشف المهاجم المفاتيح التي تُسبب تصادم جدول التجزئة الخاص بك، فستكون هذه هي المفاتيح الوحيدة التي ستراها لفترة من الوقت.
يستحق الوضع المتوسط نظرةً متأنيةً عندما يكون السيناريو السيئ نادر الحدوث. تُعدّ خوارزمية الفرز السريع (Quicksort) خير مثال على ذلك، إذ يبلغ متوسط زمنها O(n log n)، لكنها تنخفض إلى O(n²) إذا تم اختيار نقاط الارتكاز بشكلٍ عشوائي على بيانات مُرتبة مسبقًا. تتغلب المكتبات القياسية على هذه المشكلة باستخدام نقاط ارتكاز عشوائية، أو عن طريق التبديل إلى خوارزمية فرز مختلفة عندما يصبح التكرار عميقًا بشكلٍ ملحوظ.
ما هو تعقيد الفضاء والفضاء المساعد؟
الذاكرة هي التكلفة الأخرى التي تتكبدها الخوارزمية. يتتبع تعقيد المساحة مقدار الذاكرة التي تحتاجها مع ازدياد حجم المدخلات، ويتم كتابتها بنفس ترميز Big O المستخدم للوقت.
جزء من تلك الذاكرة هو المدخلات نفسها، والتي تدفع ثمنها بغض النظر عما تفعله بها. أما الجزء الذي تتحكم فيه فعليًا فيُسمى المساحة الإضافية، أي الأشياء الإضافية التي يُخصصها برنامجك أثناء عمله، مثل المتغيرات المؤقتة والمصفوفات الجديدة، بالإضافة إلى مكدس الاستدعاءات الذي لا يتذكره أحد حتى يُسبب مشكلة.
بعض الحالات السريعة:
- يتطلب تبديل متغيرين بضعة خانات بغض النظر عن أي شيء آخر، لذا فإن المساحة المساعدة هي O(1).
- نسخ قائمة مكونة من n عنصرًا إلى قائمة جديدة يكلفك O(n) من الذاكرة الإضافية.
- يؤدي التكرار بعمق n مستوى إلى ترك n إطارًا على المكدس، وهو ما يمثل مساحة O(n) على الرغم من أنك لم تقم أبدًا بإنشاء مصفوفة.
شاهدتُ مطورًا مبتدئًا يُضيّع فترة ما بعد الظهر في محاولة حل تلك المشكلة الأخيرة. بدت دالته التكرارية وكأنها لا تستخدم أي ذاكرة على الإطلاق، ولكن كل استدعاء غير مكتمل كان معلقًا على المكدس في انتظار عودة الاستدعاءات الأعمق، وعند إدخال قيمة كبيرة، توقف كل شيء بسبب تجاوز سعة المكدس.
تعتمد الكثير من عمليات التحسين على المفاضلة بين الذاكرة والوقت، أو العكس. تعمل تقنية التخزين المؤقت على تخزين النتائج التي تم حسابها مسبقًا، مما يقلل زمن حساب فيبوناتشي البسيط من O(2ⁿ) إلى O(n) مقابل O(n) من الذاكرة. أما جداول التجزئة، فتتيح لك متوسط O(1) من عمليات البحث عن طريق تخصيص مساحة في مجموعات البيانات. على خادم مزود بذاكرة وصول عشوائي (RAM) سعتها 64 جيجابايت، تُعد هذه المفاضلة خيارًا بديهيًا، ولكن على متحكم دقيق أو داخل عقد ذكي، قد تحتاج إلى إعادة النظر في الأمر.
تعقيد الوقت والمساحة لهياكل البيانات الشائعة
يُعد اختيار بنية البيانات المناسبة عادةً أفضل من إجراء تعديلات دقيقة على أي شيء داخل حلقة التكرار. متوسط تكاليف الحالات التي ستستخدمها غالبًا:
| بنية البيانات | وصول | يبحث | أدخل | يمسح | فضاء |
|---|---|---|---|---|---|
| المصفوفة | O(1) | على) | على) | على) | على) |
| قائمة مرتبطة | على) | على) | O(1) | O(1) | على) |
| جدول التجزئة | غير متوفر | O(1) | O(1) | O(1) | على) |
| شجرة بحث ثنائية متوازنة | O(log n) | O(log n) | O(log n) | O(log n) | على) |
| كومة ثنائية | O(1) للحد الأدنى/الأقصى | على) | O(log n) | O(log n) | على) |
ملاحظتان: عمليات الإضافة والحذف في القوائم المتصلة لا تتجاوز دقتها O(1) إلا إذا كنتَ تمتلك العقدة بالفعل. وقد تصل دقة جدول التجزئة إلى O(n) عند حدوث تصادمات بين العديد من المفاتيح.
تختلف خوارزميات الفرز بنفس القدر:
| خوارزمية الفرز | أفضل | متوسط | أسوأ | مساحة إضافية |
|---|---|---|---|---|
| فرز الفقاعات | على) | O(n²) | O(n²) | O(1) |
| فرز الدمج | O(n log n) | O(n log n) | O(n log n) | على) |
| فرز سريع | O(n log n) | O(n log n) | O(n²) | O(log n) |
| فرز الكومة | O(n log n) | O(n log n) | O(n log n) | O(1) |
تتميز خوارزمية فرز الدمج بإمكانية التنبؤ بها، لكنها تتطلب ذاكرة إضافية. أما خوارزمية فرز الكومة فتُفرز البيانات في مكانها وتحافظ على أسوأ حالة. وعلى الرغم من أن خوارزمية الفرز السريع تُعدّ أسوأ حالة ممكنة، إلا أنها تميل إلى التفوق عمليًا.
تعقيد الوقت في تقنية البلوك تشين والعقود الذكية
هنا تكمن المتعة. على خادمك الخاص، قد تُهدر خوارزمية غير دقيقة موارد المعالج، وربما تُزعج المستخدم. أما على إيثيريوم أو أي سلسلة EVM أخرى، فهي تُهدر المال. كل عملية تنفيذية يُجريها عقد ذكي تُكلّف رسومًا تُدفع بعملة السلسلة الأصلية، لذا يظهر عدد عملياتك كبند في فاتورة أحدهم. بعبارة أخرى، سوء التعقيد الزمني له ثمنه.
لنفترض أن لديك عقدًا يُمرر على جميع حاملي الرموز لدفع المكافآت. قيمة O(n)، وتزداد رسوم الغاز تدريجيًا مع كل حامل جديد. في يوم الإطلاق، لا أحد يلاحظ ذلك.
ثم تستمر قائمة حاملي العملات في النمو. في أحد الأيام، يحتاج الدفع إلى كمية من الغاز تتجاوز حد الغاز المسموح به في الكتلة الواحدة. بعد ذلك، لا يمكن إتمام المعاملة. ليس الأمر "بطيئًا"، بل ببساطة لا تنجح أبدًا، وتبقى الأموال المنتظرة عالقة. يصنف المدققون مثل هذه الحلقات غير المحدودة ضمن هجمات حجب الخدمة، وهذا منطقي.
يكمن الحل في التفكير المعقد، بكل بساطة:
- قسّم العمل إلى دفعات ذات حجم ثابت عبر عدة معاملات.
- اقلبها بحيث يحصل كل مستخدم على مكافأته الخاصة. كل مكالمة هي O(1).
- استبدل الحلقة ببرهان ميركل.
أحب براهين ميركل كمثال على أهمية لوغاريتم n على سلسلة الكتل. تقوم شجرة ميركل بتجزئة كمية كبيرة من البيانات إلى تجزئة جذرية واحدة.
لإثبات انتماء عنصر واحد إلى مجموعة من n عنصرًا، تحتاج إلى حوالي log₂(n) من التجزئات. بالنسبة لمليون عنصر، يكون هذا العدد حوالي 20. وليس مليونًا. تعتمد عمليات الإنزال الجوي للعملات الرقمية على هذا، وتستخدم محافظ البيتكوين الخفيفة نفس الحيلة لتأكيد المعاملة دون تنزيل الكتلة بأكملها.
خارج سلسلة الكتل، الأمر سيان. تخيّل نظام دفع خلفي يُطابق كل معاملة واردة على سلسلة الكتل مع فاتورة من خلال فحص جميع الفواتير المفتوحة. يستغرق هذا النظام O(n) لكل عملية دفع، ويزداد بطئًا مع نمو المتجر. ضع الفواتير في خريطة تجزئة مُفهرسة بالعنوان أو المعرّف، وسيصبح كل تطابق O(1). وإذا كنت تُفضّل عدم بناء هذا النظام ومراقبته بنفسك، فإن بوابة دفع العملات الرقمية مثل Plisio تُنجز ذلك نيابةً عنك.