Giải thích về độ phức tạp thời gian và độ phức tạp không gian của thuật toán.
Hãy tưởng tượng hai chương trình thực hiện cùng một công việc. Cung cấp cho mỗi chương trình một nghìn bản ghi và bạn không thể phân biệt được chúng. Nhưng nếu cung cấp cho chúng một tỷ bản ghi, một chương trình sẽ hoàn thành trước khi bạn kịp nhả phím Enter, trong khi chương trình kia vẫn đang miệt mài làm việc cho đến tận thứ Ba tuần sau.
Cùng một chiếc máy tính xách tay. Cùng một bộ dữ liệu. Điều khác biệt giữa chúng là độ phức tạp về thời gian, đó chỉ đơn giản là tên gọi cho tốc độ tăng khối lượng công việc của thuật toán khi bạn cung cấp thêm dữ liệu đầu vào.
Chúng ta sẽ cùng tìm hiểu thuật ngữ này thực sự có nghĩa là gì, cách ký hiệu Big O thể hiện nó, cách tính toán nó từ một đoạn mã thực tế và độ phức tạp về không gian xuất hiện ở đâu. Sau đó, ở phần cuối, nơi mà tất cả những điều này không còn là bài tập về nhà nữa mà bắt đầu tốn tiền thật: hợp đồng thông minh.
Độ phức tạp thời gian của thuật toán là gì?
Hãy tạm quên giây đi. Độ phức tạp thời gian tính bằng số bước. Các phép so sánh, phép gán, một vài phép toán số học ở đây và đó, và bạn viết tổng số bước dưới dạng một hàm của n, là kích thước đầu vào.
Đây là chức năng nhàm chán nhất mà bạn có thể tưởng tượng:
python def print_all(items): for item in items: print(item)
Mười món đồ? Mười vòng lặp. Mười nghìn món? Mười nghìn vòng lặp.
Công việc tăng theo đường thẳng song song với đầu vào, vì vậy chúng ta gọi nó là O(n).
Giờ thì, có lẽ mỗi chuyến đi thực sự tốn ba thao tác nhỏ thay vì một. Được rồi, vậy là 3n. Thành thật mà nói, chẳng ai quan tâm cả, bởi vì việc tăng gấp đôi danh sách vẫn làm tăng gấp đôi khối lượng công việc, và đường cong tăng trưởng đó mới là điều chúng ta cần. Con số chính xác bị bỏ qua một cách cố ý.
Đó cũng là lý do tại sao mọi khóa học về Cấu trúc dữ liệu và Thuật toán (DSA) và một nửa số cuộc phỏng vấn lập trình đều nhấn mạnh vào độ phức tạp thời gian. Nếu bạn có thể đọc được độ phức tạp của một thuật toán chỉ bằng cách nhìn vào nó, bạn có thể đoán được nó sẽ hoạt động như thế nào với dữ liệu đầu vào mà bạn chưa từng thử nghiệm. Mà trong môi trường sản xuất, đó lại là phần lớn dữ liệu.
Vì sao thời gian thực thi là một thước đo không chính xác về hiệu suất của thuật toán
Vậy tại sao không chạy chương trình bằng bộ đếm thời gian? Nhiều người làm vậy, và tôi hiểu. Vấn đề là thời gian thực thi sẽ kéo theo một loạt những thứ mà thuật toán của bạn không hề liên quan đến:
- Phần cứng. Chiếc máy tính xách tay 5 năm tuổi của tôi và một thiết bị lưu trữ đám mây hoàn toàn mới sẽ cho ra những con số khác nhau hoàn toàn khi thực hiện cùng một kịch bản.
- Ngôn ngữ lập trình. Viết cùng một vòng lặp bằng C và Python, bạn có thể thấy sự khác biệt gấp 10 lần, hoặc hơn.
- Tải hệ thống. Một số trình cập nhật nền được kích hoạt, trình thu gom rác thức dậy, bộ nhớ cache trống. Kết quả của bạn được di chuyển.
- Bất kể dữ liệu đầu vào bạn lấy là gì. Thuật toán sắp xếp có thể hoạt động nhanh trên dữ liệu gần như đã được sắp xếp nhưng lại hoạt động rất chậm trên dữ liệu đã bị xáo trộn.
Đồng hồ bấm giờ chỉ cho phép bạn thực hiện một lần đo với một dữ liệu đầu vào. Nhưng nếu bạn yêu cầu nó thực hiện với lượng dữ liệu gấp 100 lần, nó sẽ không thể làm được gì.
Số bước thực thi không hề thay đổi. Cùng một thuật toán, cùng một dữ liệu đầu vào, và bạn sẽ nhận được cùng một số bước cho dù đó là Rust trên máy chủ rack hay JavaScript trên điện thoại của ai đó. Đó là lý do tại sao độ phức tạp về thời gian là một cuộc cạnh tranh công bằng giữa hai giải pháp trước khi bạn tiến hành đo hiệu năng. Tôi vẫn khuyên bạn nên đo hiệu năng sau đó, dù sao thì đó cũng là một câu hỏi khác.
Giải thích về ký hiệu Big O và các ký hiệu tiệm cận khác
Sách giáo khoa gọi đây là ký hiệu tiệm cận, nghe có vẻ phức tạp hơn thực tế. Bạn cho n trở nên rất lớn và không còn quan tâm đến những chi tiết nhỏ nữa, do đó các hệ số nhân không đổi và các giá trị đầu vào nhỏ sẽ biến mất và chỉ còn lại đường cong tăng trưởng. Có ba ký hiệu đáng để biết:
| Ký hiệu | Nó mô tả điều gì? | Ý nghĩa đơn giản | Ví dụ |
|---|---|---|---|
| Big O, O(f(n)) | Giới hạn trên | Thuật toán này không phát triển nhanh hơn f(n) | Tìm kiếm tuyến tính có độ phức tạp O(n) |
| Big-Omega, Ω(f(n)) | Giới hạn dưới | Thuật toán cần ít nhất f(n) công việc | Mọi thuật toán sắp xếp so sánh đều là Ω(n log n) |
| Theta lớn, Θ(f(n)) | Buộc chặt | Giới hạn trên và giới hạn dưới trùng khớp. | Thuật toán sắp xếp trộn là Θ(n log n) |
Trên thực tế, bạn sẽ thấy ký hiệu Big O xuất hiện khoảng 95% thời gian. Nó đặt ra một giới hạn trên, có nghĩa là thời gian chạy sẽ không tăng nhanh hơn tốc độ bên trong dấu ngoặc đơn. Lần đầu tiên tôi nhận xét mã nguồn ở một công ty thực tế, một lập trình viên cấp cao đã viết "O(n²), vui lòng sửa" bên cạnh một vòng lặp lồng nhau, và ý họ muốn nói là độ phức tạp thời gian trong trường hợp xấu nhất là bậc hai và danh sách sẽ trở nên dài hơn rất nhiều.
Omega và Theta chủ yếu xuất hiện trong các khóa học đại học về phân tích thuật toán, và tôi nghĩ mình đã không gõ cả hai cái này ở chỗ làm trong nhiều năm rồi. Big O thắng thế vì nó trả lời câu hỏi thực tế mà mọi người đặt ra trong một cuộc họp, đó là "tình hình sẽ tồi tệ đến mức nào nếu lưu lượng truy cập tăng gấp ba lần?"
Có một chi tiết kỹ thuật đã làm tôi bối rối một thời gian. Vì Big O chỉ là giới hạn trên, nên một hàm O(n) cũng là O(n²), nói một cách chính xác, giống như một người cao 5 feet "dưới 7 feet". Điều này đúng nhưng vô dụng. Ai cũng đưa ra giới hạn chặt chẽ nhất mà họ có thể biện minh và tôi cũng sẽ làm vậy.
Các lớp độ phức tạp thời gian phổ biến kèm ví dụ
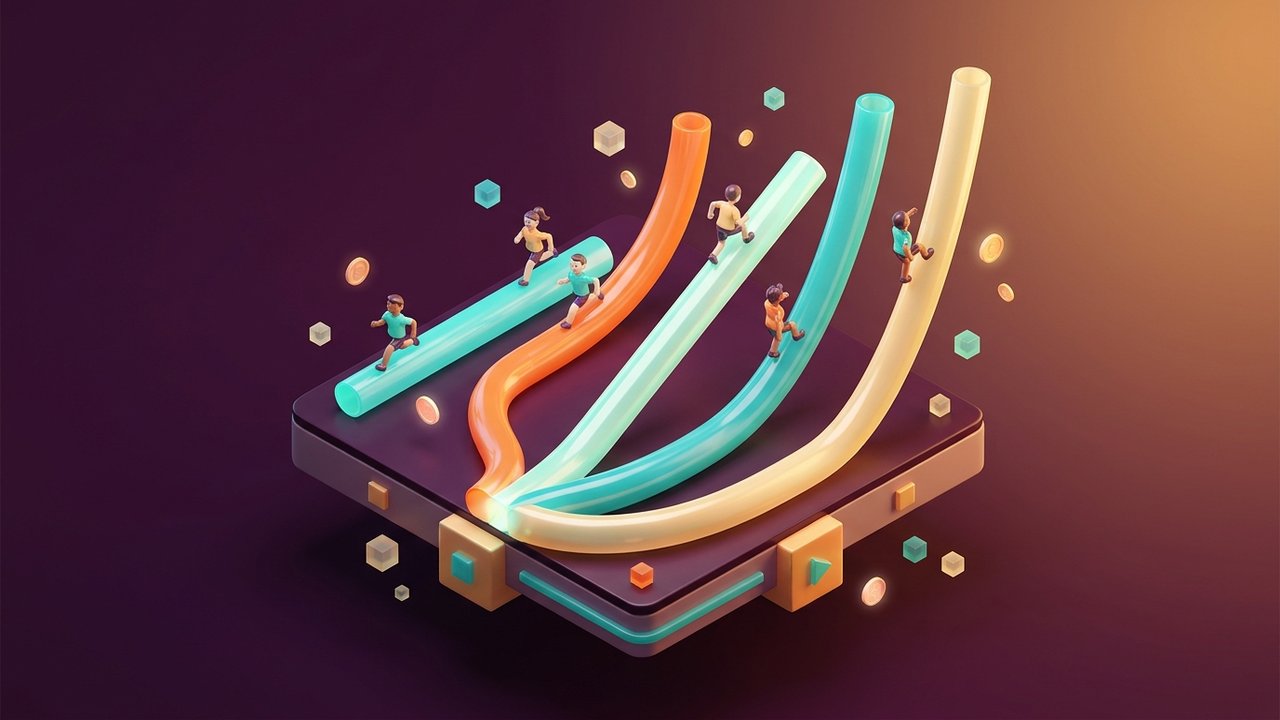
Bạn sẽ không thấy nhiều lớp như vậy trong mã nguồn thực tế, có lẽ chỉ khoảng bảy lớp nếu tính cả những lớp phức tạp. Đây là chi phí ước tính cho mỗi lớp khi n = 1.000:
| Lớp học | Tên | Ví dụ điển hình | Các phép toán tại n = 1.000 |
|---|---|---|---|
| O(1) | Không thay đổi | Chỉ mục mảng, tra cứu bảng băm | 1 |
| O(log n) | Logarit | Tìm kiếm nhị phân | ~10 |
| TRÊN) | Tuyến tính | Quét danh sách | 1.000 |
| O(n log n) | Tuyến tính-thần số | Sắp xếp trộn, sắp xếp nhanh (trung bình) | ~10.000 |
| O(n²) | bậc hai | Vòng lặp lồng nhau, thuật toán sắp xếp nổi bọt | 1.000.000 |
| O(2ⁿ) | Theo cấp số mũ | Fibonacci đệ quy đơn giản | Nhiều hơn cả nguyên tử trong vũ trụ |
| TRÊN!) | Giai thừa | Người bán hàng lưu động dùng sức mạnh thô bạo | Thậm chí còn lớn hơn |
O(1): Thời gian hằng số
Cho dù từ điển Python của bạn có mười khóa hay mười triệu khóa, việc lấy một khóa ra có chi phí gần như nhau, và việc đọc các mục[5] từ một danh sách cũng vậy. Tính phẳng đó chính là điểm mấu chốt của thời gian không đổi.
O(log n): Thời gian logarit
Tôi coi đây như những thuật toán "đoán số giữa 1 và 100", trong đó mỗi lần đoán loại bỏ một nửa số lựa chọn còn lại. Tìm kiếm nhị phân thực hiện chính xác điều đó trên một danh sách đã được sắp xếp:
Hàm Python: def binary_search(arr, target): lo, hi = 0, len(arr) - 1 while lo <= hi: mid = (lo + hi) // 2 if arr[mid] == target: return mid if arr[mid] < target: lo = mid + 1 else: hi = mid - 1 return -1
Với một tỷ mục đã được sắp xếp, chỉ cần khoảng 30 phép so sánh, trong khi nếu xử lý từng mục một thì có thể mất đến cả tỷ mục, và tôi vẫn luôn thấy điều đó thật buồn cười.
O(n) và O(n log n)
Thuật toán tuyến tính duyệt qua từng phần tử một số lần cố định, giống như cách bạn tìm kiếm số lớn nhất trong một cột của bảng tính bằng mắt thường. Độ phức tạp O(n log n) là nền tảng của thuật toán sắp xếp tốt. Thuật toán sắp xếp trộn (Merge sort) chia danh sách thành các mục đơn lẻ (log n cấp độ chia) và sau đó thực hiện một lượt duyệt tuyến tính cho mỗi cấp độ trong khi trộn, vì vậy thời gian chạy của nó không thay đổi bất kể dữ liệu được sắp xếp hay xáo trộn.
O(n²) và Tệ hơn
Mã bậc hai hầu như luôn có một vòng lặp lồng bên trong một vòng lặp khác, giống như phép kiểm tra trùng lặp này so sánh mọi cặp:
python def has_duplicate(items): for i in range(len(items)): for j in range(i + 1, len(items)): if items[i] == items[j]: return True return False
Sự tăng trưởng theo cấp số mũ và giai thừa còn tệ hơn nhiều. Phương pháp Fibonacci đệ quy trong sách giáo khoa cứ giải đi giải lại cùng một bài toán con, vì vậy mỗi lần tăng n lên gấp đôi khối lượng công việc. Ở n = 20, bạn sẽ không nhận thấy sự khác biệt; nhưng ở n = 60, bạn có thể đi nấu ăn, ăn xong, rửa bát, mà công việc vẫn chưa hoàn thành.
Cách tính độ phức tạp thời gian từng bước một
Bạn hầu như không bao giờ cần đến bằng chứng chính thức để tính toán độ phức tạp thời gian. Tôi thường nhẩm qua danh sách này trong đầu và nó bao gồm hầu hết các đoạn mã mà tôi thấy:
- Xác định n. Quyết định kích thước đầu vào là gì: độ dài của một danh sách, số nút trong một đồ thị, số chữ số trong một số.
- Đếm số công việc trong mỗi dòng. Các câu lệnh đơn giản (gán, so sánh, phép toán số học) có chi phí O(1).
- Cộng các khối tuần tự. Hai vòng lặp nối tiếp nhau, mỗi vòng lặp thực hiện trên n, cho ta n + n = 2n.
- Nhân các khối lồng nhau. Một vòng lặp n bên trong một vòng lặp khác cũng n sẽ cho kết quả n × n = n².
- Bỏ các hằng số. 2n trở thành n, và 500 trở thành 1.
- Chỉ giữ lại số hạng trội. Trong n² + n, phần n² chiếm ưu thế hơn hẳn các phần còn lại khi n tăng lên.
Bài toán làm nhanh. Kết quả tính được là T(n) = 3n² + 5n + 2. Thêm một triệu vào: 3n² là ba nghìn tỷ, 5n là năm triệu. Sai số làm tròn. Gọi nó là O(n²), xong.
Các vòng lặp nhảy lung tung thay vì bước từng bước một sẽ tinh vi hơn:
python def count_halvings(n): steps = 0 while n > 1: n //= 2 steps += 1 return steps
Mỗi lần lặp sẽ giảm n xuống một nửa, vì vậy vòng lặp while này sẽ dừng lại sau khoảng log₂(n) vòng. Về cơ bản, đó chính là câu trả lời cho câu hỏi "khi nào độ phức tạp thời gian là O(log n)?". Nếu phần còn lại giảm đi một hằng số sau mỗi bước, thì bạn đã đạt được điều đó.
Đệ quy cần thêm một công cụ nữa, đó là công thức truy hồi. Thuật toán sắp xếp trộn thực hiện hai công việc có kích thước bằng một nửa rồi trộn lại, vì vậy T(n) = 2T(n/2) + n. Định lý chính là một bảng tóm tắt cho các công thức truy hồi có dạng đó, và đối với công thức này, nó cho ra kết quả O(n log n).
Và một quy tắc kinh nghiệm từ lập trình thi đấu mà tôi thường dựa vào: một máy tính thông thường xử lý được khoảng 10⁸ phép toán đơn giản mỗi giây. Con số này khá sơ bộ, nhưng đủ để kiểm tra độ phức tạp thời gian của lời giải trước khi nộp bài. Với n = 10⁵, O(n²) xấp xỉ 10¹⁰ phép toán, vậy là bạn sẽ hết thời gian. O(n log n) thì dưới 2 triệu phép toán. Vậy là vượt qua dễ dàng.
Phân tích trường hợp xấu nhất, trường hợp tốt nhất và trường hợp trung bình
Nếu cung cấp cùng một thuật toán với các đầu vào khác nhau, khối lượng công việc có thể thay đổi rất nhiều. Thuật toán tìm kiếm tuyến tính minh họa điều này rất rõ ràng:
- Trường hợp tốt nhất: thứ bạn muốn đang nằm ngay phía trước. Chỉ cần một lần so sánh là bạn đã bị loại.
- Trường hợp xấu nhất: nó nằm ở cuối cùng, hoặc hoàn toàn không có. Đó là n phép so sánh.
- Trường hợp trung bình: nếu nó có thể ở bất cứ đâu với xác suất bằng nhau, bạn sẽ kiểm tra trung bình khoảng n/2 lần. Vẫn là O(n), cần lưu ý điều đó.
Nếu bạn hỏi một nhà phát triển về "độ phức tạp" của một thứ gì đó, họ gần như luôn sẽ đưa ra độ phức tạp về thời gian trong trường hợp xấu nhất, bởi vì con số đó là một lời hứa mà bạn có thể dựa vào để lập kế hoạch.
Giả sử API của bạn xử lý một yêu cầu trong thời gian O(n) ở trường hợp xấu nhất. Tuyệt vời, giờ bạn đã biết yêu cầu chậm nhất hoạt động như thế nào, và bạn cũng được bảo vệ khi ai đó cố tình gửi cho bạn dữ liệu rác. Mọi người hoàn toàn có thể làm điều này: nếu kẻ tấn công tìm ra những khóa nào gây ra xung đột trong bảng băm của bạn, thì đó sẽ là những khóa duy nhất bạn thấy trong một thời gian.
Trường hợp trung bình đáng để xem xét khi kịch bản xấu hiếm khi xảy ra. Thuật toán Quicksort là ví dụ điển hình ở đây, trung bình có độ phức tạp O(n log n) nhưng có thể lên đến O(n²) nếu bạn chọn phần tử chốt một cách đơn giản trên dữ liệu đã được sắp xếp. Các thư viện chuẩn khắc phục điều đó bằng cách sử dụng các phần tử chốt ngẫu nhiên, hoặc bằng cách chuyển sang thuật toán sắp xếp khác khi quá trình đệ quy đi sâu một cách đáng ngờ.
Độ phức tạp không gian và không gian phụ trợ là gì?
Bộ nhớ là một khoản chi phí khác mà thuật toán tiêu tốn. Độ phức tạp không gian theo dõi lượng bộ nhớ cần thiết khi kích thước đầu vào tăng lên, và bạn viết nó bằng cùng ký hiệu Big O như thời gian.
Một phần bộ nhớ đó là chính dữ liệu đầu vào, và bạn phải trả phí cho nó bất kể bạn làm gì với nó. Phần mà bạn thực sự kiểm soát được gọi là không gian phụ trợ, nghĩa là những thứ bổ sung mà mã của bạn cấp phát trong quá trình hoạt động, chẳng hạn như các biến tạm thời và mảng mới, cộng với ngăn xếp cuộc gọi mà không ai nhớ đến cho đến khi nó gây ra lỗi.
Một vài ví dụ nhanh:
- Việc hoán đổi hai biến cần một vài vị trí bất kể điều gì khác, vì vậy nó có không gian phụ trợ O(1).
- Việc sao chép một danh sách gồm n mục vào một danh sách mới sẽ tiêu tốn của bạn O(n) bộ nhớ bổ sung.
- Đệ quy sâu n cấp sẽ để lại n khung nằm trên ngăn xếp, tức là không gian O(n) ngay cả khi bạn chưa bao giờ xây dựng một mảng.
Tôi đã chứng kiến một lập trình viên trẻ mất cả buổi chiều vì lỗi đó. Hàm đệ quy của họ trông như không sử dụng bộ nhớ nào cả, nhưng mỗi lời gọi chưa hoàn thành đều bị giữ lại trên ngăn xếp chờ các lời gọi sâu hơn trả về, và khi nhận được dữ liệu đầu vào lớn, toàn bộ chương trình bị sập do tràn ngăn xếp.
Nhiều tối ưu hóa chỉ đơn giản là đánh đổi bộ nhớ lấy thời gian hoặc ngược lại. Ghi nhớ (memoization) lưu trữ kết quả bạn đã tính toán, giúp giảm độ phức tạp của thuật toán Fibonacci đơn giản từ O(2ⁿ) xuống O(n) thời gian đổi lại O(n) bộ nhớ. Bảng băm (hash table) mang lại cho bạn thời gian tìm kiếm trung bình O(1) bằng cách dành không gian cho các ngăn chứa (bucket). Trên một máy chủ có 64 GB RAM, sự đánh đổi đó thường rất dễ dàng, nhưng trên bộ vi điều khiển hoặc bên trong một hợp đồng thông minh, bạn sẽ phải suy nghĩ kỹ hơn.
Độ phức tạp về thời gian và không gian của các cấu trúc dữ liệu thông thường
Việc lựa chọn cấu trúc dữ liệu phù hợp thường hiệu quả hơn việc tinh chỉnh từng chi tiết nhỏ bên trong vòng lặp. Chi phí trung bình cho những cấu trúc dữ liệu bạn sẽ sử dụng nhiều nhất:
| Cấu trúc dữ liệu | Truy cập | Tìm kiếm | Chèn | Xóa bỏ | Không gian |
|---|---|---|---|---|---|
| Mảng | O(1) | TRÊN) | TRÊN) | TRÊN) | TRÊN) |
| Danh sách liên kết | TRÊN) | TRÊN) | O(1) | O(1) | TRÊN) |
| Bảng băm | không áp dụng | O(1) | O(1) | O(1) | TRÊN) |
| Cây tìm kiếm nhị phân cân bằng | O(log n) | O(log n) | O(log n) | O(log n) | TRÊN) |
| Vùng nhớ nhị phân | O(1) cho min/max | TRÊN) | O(log n) | O(log n) | TRÊN) |
Hai chú thích. Việc chèn và xóa trong danh sách liên kết chỉ có độ phức tạp O(1) nếu bạn đã giữ nút đó. Và bảng băm có thể trở nên phức tạp O(n) khi có nhiều khóa xung đột.
Các thuật toán sắp xếp cũng đa dạng không kém:
| Thuật toán sắp xếp | Tốt nhất | Trung bình | Tồi tệ nhất | Không gian phụ trợ |
|---|---|---|---|---|
| Sắp xếp nổi bọt | TRÊN) | O(n²) | O(n²) | O(1) |
| Sắp xếp trộn | O(n log n) | O(n log n) | O(n log n) | TRÊN) |
| Sắp xếp nhanh | O(n log n) | O(n log n) | O(n²) | O(log n) |
| Sắp xếp đống | O(n log n) | O(n log n) | O(n log n) | O(1) |
Thuật toán sắp xếp trộn (Merge sort) có thể dự đoán được kết quả nhưng cần thêm bộ nhớ. Thuật toán sắp xếp đống (Heap sort) sắp xếp tại chỗ và giữ nguyên trường hợp xấu nhất. Thuật toán sắp xếp nhanh (Quicksort), mặc dù có giới hạn xấu hơn, nhưng thường hiệu quả hơn trong thực tế.
Độ phức tạp về thời gian trong Blockchain và Hợp đồng thông minh
Đây mới là điều thú vị. Trên máy chủ của riêng bạn, một thuật toán cẩu thả sẽ lãng phí CPU và có thể gây khó chịu cho người dùng. Trên Ethereum hoặc bất kỳ chuỗi EVM nào, nó sẽ lãng phí tiền bạc. Mỗi mã lệnh mà hợp đồng thông minh thực thi đều tốn phí gas, được thanh toán bằng đồng tiền gốc của chuỗi, vì vậy số lượng thao tác của bạn sẽ hiển thị như một dòng trên hóa đơn của ai đó. Nói cách khác, độ phức tạp thời gian kém sẽ đi kèm với một cái giá phải trả.
Giả sử bạn có một hợp đồng lặp qua từng người nắm giữ token để trả thưởng. Độ phức tạp O(n), và phí gas tăng lên với mỗi người nắm giữ mới. Vào ngày ra mắt, không ai nhận thấy điều đó.
Sau đó, danh sách người nắm giữ tiếp tục tăng lên. Một ngày nào đó, việc thanh toán cần nhiều gas hơn giới hạn gas của khối, tức là giới hạn lượng gas mà một khối duy nhất có thể chứa. Sau đó, giao dịch không thể thực hiện được. Không phải là "nó chậm". Mà là nó không bao giờ thành công, và bất kỳ khoản tiền nào đang chờ đợi phía sau chức năng đó về cơ bản đều bị kẹt. Các kiểm toán viên coi những vòng lặp vô hạn như thế này là tấn công từ chối dịch vụ, và điều đó hoàn toàn hợp lý.
Giải pháp nằm ở tư duy phức tạp, đơn giản vậy thôi:
- Chia nhỏ công việc thành các lô có kích thước cố định và thực hiện qua nhiều giao dịch.
- Đảo ngược lại để mỗi người dùng nhận phần thưởng của riêng họ. Mỗi lần gọi là O(1).
- Thay thế vòng lặp bằng chứng minh Merkle.
Tôi thích bằng chứng Merkle như một ví dụ minh họa tại sao log n lại quan trọng đến vậy trên chuỗi khối. Cây Merkle băm một lượng lớn dữ liệu thành một băm gốc duy nhất.
Để chứng minh một mục thuộc về một tập hợp gồm n mục, bạn cần khoảng log₂(n) hàm băm. Đối với một triệu mục, con số đó xấp xỉ 20. Không phải một triệu. Các đợt airdrop dựa vào điều này, và các ví Bitcoin nhẹ cũng sử dụng thủ thuật tương tự để xác nhận giao dịch mà không cần tải xuống toàn bộ khối.
Ngoài chuỗi, cũng tương tự. Hãy tưởng tượng một hệ thống thanh toán phụ trợ khớp từng giao dịch blockchain đến với một hóa đơn bằng cách quét mọi hóa đơn đang mở. Độ phức tạp O(n) cho mỗi lần thanh toán, và nó sẽ chậm hơn khi cửa hàng phát triển. Đặt các hóa đơn vào một bản đồ băm được khóa bằng địa chỉ hoặc ID và mỗi lần khớp có độ phức tạp O(1). Và nếu bạn không muốn tự xây dựng và quản lý hệ thống đó, một cổng thanh toán tiền điện tử như Plisio sẽ làm điều đó cho bạn.